Latex

Mostrando entradas con la etiqueta R estadística EDA. Mostrar todas las entradas

domingo, 19 de agosto de 2012

Cuando los supuestos subyacentes no se cumplen

En nuestra nota anterior hemos descripto los cuatro supuestos básicos que subyacen en una mayoría de modelos estadísticos. Ahora investigaremos qué sucede cuando alguno(s) de ello(s) no se cumple(n).

Los cuatro supuestos básicos eran:
  1. aleatoriedad
  2. posición fija
  3. dispersión fija
  4. distribución fija 

Consecuencias de no aleatoriedad

Si el supuesto aleatoriedad no se cumple, entonces:
  1. Todos los tests estadísticos quedan invalidados.
  2. Los rangos de variación pierden significado.
  3. El cálculo de muestra mínima o suficiente carece de sentido. En un escenario totalmente no aleatorio, tomar muestras carece de sentido.
  4. El modelo respuesta = constante + error pierde sentido.
  5. La estimación de sus parámetros a través de muestras se torna sospechoso.
Un caso específico de no aleatoriedad es la existencia de autocorrelación. La autocorrelación es la relación que existe entre la variable aleatoria $Y_t$ y la misma variable k períodos antes $Y_{t-k}$. La autocorrelación sería una no-aleatoriedad en base al tiempo de observación. La autocorrelación se detecta con el gráfico de lags que hemos visto o con un correlograma.
Si los datos están afectados por autocorrelación, entonces:
  1. Los datos adyacentes están relacionados.
  2. No se tienen n muestras independientes.
  3. Los outliers son más difíciles de detectar.

Consecuencias de no existir un parámetro de posición fijo

La estimación usual de posición es la media muestral:
$${\bar{Y} = \frac{1}{N}}{\sum\limits_{j=1}^{N} Y_i}$$
Si el supuesto de posición fija no se cumple,
  1. La posición estimada puede tener tendencia.
  2. La fórmula usual de incertidumbre de la media:  $${s(\bar{Y}) = \frac{1}{\sqrt{N(N-1)}}}\sqrt{\sum\limits_{j=1}^{N} {(Y_i - \bar{Y})}^2}$$ puede ser inválida y su valor numérico sería menor.
  3. La estimación de otra medida de posición simple sería pobre y sesgada. 

Consecuencias de no existir un parámetro de dispersión fijo

La estimación usual de dispersión es el desvío estándar:
$${s(Y) = \frac{1}{\sqrt{N-1}}}\sqrt{\sum\limits_{j=1}^{N} {(Y_i - \bar{Y})}^2}$$
Si el supuesto de dispersión fija no se cumple,
  1. La varianza puede tener tendencia.
  2. La estimación simple de la varianza pierde significado y puede estar sesgada.

Consecuencias de no conocer la distribución subyacente

Rutinariamente se utiliza la media (promedio) para estimar el "medio" de una distribución de probabilidad. Así también se utiliza la fórmula de desvío estándar para estimarle un rango de variación:
$${s(\bar{Y}) = \frac{1}{\sqrt{N(N-1)}}}\sqrt{\sum\limits_{j=1}^{N} {(Y_i - \bar{Y})}^2}$$
No es muy conocido que dicha fórmula tiene supuestos de una distribución normal subyacente (aparte de un buen tamaño de muestra), y si no se cumple, estos márgenes quedan invalidados.
Para algunos tipos de distribuciones, sobre todo las distribuciones con una distribución asimétrica importante, la media como medida de posición resumen es una elección pobre. Cada distribución tiene una medida de posición óptima para elegir; se recomienda elegir aquella que menos variabilidad y ruido tenga. Esta elección óptima podría ser, por ejemplo, la mediana, el rango medio, la moda, etc... Esto implica tener que estimar la distribución subyacente, y una vez conocida la distribución de probabilidad, elegir el estimador de posición.
Trataremos estas técnicas de estimación en una nota futura. lo importante es estar conscientes que si el histograma y gráfico p-p Plot no muestran la distribución esperada (habiendo ya afirmado la componente determinística del modelo), es mejor dedicar tiempo a estimar la distribución subyacente.

Otras consecuencias de subestimar la distribución subyacente son:

 En la distribución

  1. La  distribución subyacente puede ir cambiando.
  2. Si sucede lo del punto 1, una estimación por única vez de la distribución subyacente es insuficiente y quedará obsoleta.
  3. La distribución subyacente puede ser marcadamente no normal
  4. La verdadera distribución de probabilidad para el error puede mantenerse desconocida y deberemos conformarnos con una aproximación. 

 En el modelo

  1. El modelo puede ir cambiando.
  2. Si sucede lo del punto 1, una estimación por única vez de la distribución subyacente es insuficiente y quedará obsoleta.
  3. El modelo respuesta = constante + error puede quedar inválido.
  4. Si no se tiene identificada la distribución correcta, una mejora necesaria al modelo puede quedar oculta.

 En el proceso

  1. El proceso puede estar fuera de control y no detectarse.
  2. El proceso puede ser impredecible y no ser consciente de ello. 
  3. El proceso puede ser no modelable.

sábado, 18 de agosto de 2012

Los 4 supuestos subyacentes básicos

Existe una base de supuestos estadísticos generales sobre los que mas o menos se posan gran parte de los fenómenos aleatorios que queremos analizar.
En esta nota trataremos de conceptualizarlos y propondremos un set de herramientas para una primer mirada exploratoria.

Supuestos subyacentes

Existen cuatro supuestos muy típicos en los análisis estadísticos, es decir, que los los datos "se comportan como...". Y son los siguientes:
  1. Aleatoriedad, o ruido blanco para series de tiempo
  2. Proveniencia de una distribución dada
  3. La distribución tiene una medida de posición fija dada
  4. La distribución tiene una medida de dispersión fija dada
La posición fija mencionada en el punto 3 puede diferir según se trate del tipo de proceso analizado, pero para problemas univariados, utilizar este supuesto implica convertir un problema típico

respuesta = componente determinístico + componente aleatorio

a lo siguiente

respuesta = constante + error

la constante sería nuestra medida de posición fija a determinar. Así pues, podemos imaginar el proceso a la mano de estar operando bajo condiciones constantes que producen una sola columna de datos con las propiedades que:
  • los datos no están correlacionados entre sí;
  • la componente aleatoria tiene una distribución fija;
  • el componente deterministico consiste en sólo una constante, y
  • el componente aleatorio tiene una variación fija.
El poder universal y la importancia de este modelo univariado es que puede ser fácilmente extendido a problemas más generales donde el componente determinístico no es una constante, sino en efecto una función de varias variables.

El punto clave es que, independientemente de cuántos factores haya, e independientemente de lo complicado que sea la función, y si el analista tiene éxito en la elección del modelo, entonces las diferencias (residuos) entre los datos de respuesta y los valores pronosticados por el modelo deben comportarse como un proceso univariado, el cual tendrá:
  • Aleatoriedad, o ruido blanco para series de tiempo
  • una distribución dada
  • una medida de posición fija dada (cero en este caso)
  • una medida de dispersión fija dada
Así, los residuos se comportan de acuerdo al modelo ideal que se asumió. Entonces las pruebas de los supuestos subyacentes sobre los residuos se convierten en una herramienta para la validación y la calidad de ajuste del modelo elegido.
Por otro lado, si los residuos del modelo escogido violan uno o más de los supuestos univariantes anteriores, entonces el modelo escogido es insuficiente y existe una oportunidad de hallar un modelo mejor.


Importancia

La predictibilidad es por lejos el objetivo más importante de un análisis estadístico. Pero para que se cumpla dicho objetivo debemos tener el proceso "bajo control estadístico", condición que se cumple cuando las cuatro condiciones mencionadas se comprueban y tenemos suficientes seguridades de que se seguirán cumpliendo en el futuro.

Técnicas gráficas para comprobar los cuatro supuestos básicos

Existe un innumerable conjunto de herramientas numéricas y gráficas para testear los cuatro supuestos. Nosotros nos centraremos en un conjunto reducido de técnicas gráficas, que aprenderemos a desarrollar con lenguaje R. Considero que las mismas cumplirán de manera simple y eficiente el análisis EDA de cualquier serie univariada. Utilizaremos el siguiente set de gráficos que pasaremos a llamar "4-plot":
  • gráfico de secuencias
  • gráfico de rezagos o diagrama de fase
  • histograma
  • gráfico de probabilidad normal o P-P Plot
Ya he tratado el histograma y otras no mencionadas (diagrama de hojas, densigrama, cajas) en una de mis primeras notas de EDA. El conjunto elegido es simple de entender y se presta muy bien a comprobar los 4 supuestos mencionados.

Construcción de los gráficos con R

A continuación detallo el código necesario para construir los gráficos. Dejé el código comentado y muy simple para que pueda ser reutilizado facilmente:

## 4-Plot
## Generando los gráficos de 4-plot para los datos.
## La variable con datos es y. Es un array univariado. No funciona con data.frame  
## El data.frame se puede convertor a array con el comando y <- as.array(y)  
 
##variable de conteo
n <- length(y)
t <- 1:n
## parámetros de gráfico
## mfrow: nro de gráficos c(nr,nc) 2x2=4, al ser mfrow y no mfcol, se enumeran por fila
## oma: márgenes externos entre gráfico y texto c(bottom, left, top, right)
## mar: márgenes internos entre área de trazado y gráfico c(bottom, left, top, right)
par(mfrow = c(2, 2),                 #2 filas por 2 columnas#
      oma = c(0, 0, 2, 0),           #márgenes externos# 
      mar = c(5.1, 4.1, 2.1, 2.1))   #márgenes internos#
 
##gráfico de secuencias
plot(t,y,ylab="Y",xlab="orden",type="l")
abline(h=mean(y), add=TRUE, col="blue")
abline(h=-2*sd(y), add=TRUE, col="blue", lty="dashed")
abline(h=2*sd(y), add=TRUE, col="blue", lty="dashed")
##gráfico de fases o lags
plot(y[-1],y[-n],xlab="Y[i-1]",ylab="Y[i]")
##gráfico de histograma
hist(y,main="",xlab="Y",ylab="f(Y)",freq=FALSE)
curve(dnorm(x,mean=mean(y),sd=sd(y)), add=TRUE, col="blue")
##gráfico QQPlot normal
qqnorm(y,main="",xlab="teórico",ylab="muestra")
qqline(y,col="blue")
mtext("4-Plot", line = 0.5, outer = TRUE) ##gráfico QQPlot normal
 
Veamos cómo funciona a través de ejemplos:
 

Ejemplo 1: números aleatorios distribuidos normalmente

Sería este el caso ideal donde se cumplen los 4 supuestos básicos. Nos servirá para presentar los gráfico en un estado "ideal".
Generamos primero una sucesión de 200 números distribuidos normalmente
 
y <- rnorm(200,0,1)
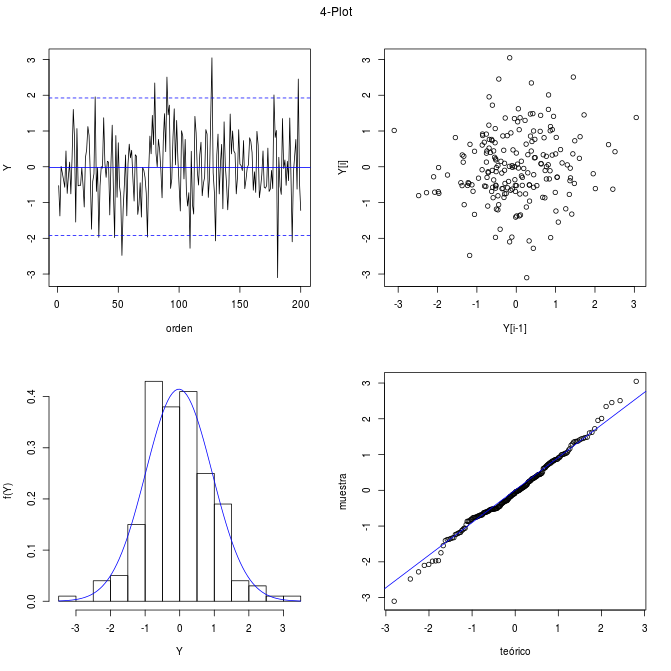
Luego ejecutamos el código R provisto en la sección anterior. El resultado debe ser similar a este:
Veamos  qué podemos aprender. Primero vayamos investigando cada uno de los 4 supuestos básicos:


  • una medida de posición fija: si la hipótesis de cumple, el gráfico de secuencias (esquina superior izquierda) debe ser uniforme y sin tendencia. Puede apreciarse ello en el gráfico.
  • una medida de dispersión fija: si la hipótesis de cumple, el gráfico de secuencias debe tener la misma amplitud sobre todo el eje x.
  • aleatoriedad o ruido blanco: en caso de no haber un comportamiento correlacionado o determinista entre los datos. El gráfico de lags no debe mostrara patrones identificables, tal como se muestra en segundo gráfico arriba a la derecha.
  • una distribución dada: en dicho caso, el histograma (esq inf izq) debe ajustar a la curva supuesta y el P-P Plot (esq inf derecha) mostrarse en línea recta. En este caso (y en el código R) la distribución subyacente es la Normal y se aprecia en los gráficos un buen ajuste a los datos.

Ejemplo 2: reflexiones de un láser

El siguiente ejemplo toma una muestra del año 1969 de 200 disparos de láser, computando su desvío en cada uno de ellos
  [1] -213 -564  -35  -15  141  115 -420 -360  203 -338 -431  194 -220 -513  154
 [16] -125 -559   92  -21 -579  -52   99 -543 -175  162 -457 -346  204 -300 -474
 [31]  164 -107 -572   -8   83 -541 -224  180 -420 -374  201 -236 -531   83   27
 [46] -564 -112  131 -507 -254  199 -311 -495  143  -46 -579  -90  136 -472 -338
 [61]  202 -287 -477  169 -124 -568   17   48 -568 -135  162 -430 -422  172  -74
 [76] -577  -13   92 -534 -243  194 -355 -465  156  -81 -578  -64  139 -449 -384
 [91]  193 -198 -538  110  -44 -577   -6   66 -552 -164  161 -460 -344  205 -281
[106] -504  134  -28 -576 -118  156 -437 -381  200 -220 -540   83   11 -568 -160
[121]  172 -414 -408  188 -125 -572  -32  139 -492 -321  205 -262 -504  142  -83
[136] -574    0   48 -571 -106  137 -501 -266  190 -391 -406  194 -186 -553   83
[151]  -13 -577  -49  103 -515 -280  201  300 -506  131  -45 -578  -80  138 -462
[166] -361  201 -211 -554   32   74 -533 -235  187 -372 -442  182 -147 -566   25
[181]   68 -535 -244  194 -351 -463  174 -125 -570   15   72 -550 -190  172 -424
[196] -385  198 -218 -536   96
  En este caso, los gráficos resultaron ser:

Verifiquemos las hipótesis:


  • una medida de posición fija: el gráfico de secuencias no presenta tendencias
  • una medida de dispersión fija: el gráfico de secuencias presenta aproximadamente la misma variación a través de todo su recorrido.
  • aleatoriedad o ruido blanco: El gráfico de lags muestra un patrón muy específico, confirmando que la serie no es aleatoria.
  • una distribución dada: siendo que se comprobó que no existe aleatoriedad, los gráficos de histograma y P-P plot no tienen un significado útil.
 Entonces concluimos que el modelo respuesta = constante + error no es aplicable para este problema y debemos buscar un mejor modelo.

Daré a continuación un modelo al cual ajustan mejor los datos, sin explicar en detalle cómo se llegó a esta nueva propuesta. Sólo diré que El gráfico de lags sugiere una función sinuidal u oscilante

siendo C una constante de nivel, alfa la amplitud, omega la frecuencia y tita la fase de la función seno.
Analizaremos los errores de medición y - y modelado para ver si el muevo modelo pudo capturar la parte determinista con éxito

t <- 1:length(y)
 
C <- -178.786
AMP <- -361.766 
FREC <- 0.302596 
PHASE <- 1.46536 
 
e <- C + AMP*sin(2*pi*FREC*t+PHASE) - y

En la última línea hemos restado la parte determinista a los datos reales. Los gráficos de residuales e son:


Verifiquemos nuevamente las hipótesis sobre los residuos o parte aleatoria:

  • una medida de posición fija: el gráfico de secuencias no presenta tendencias
  • una medida de dispersión fija: el gráfico de secuencias presenta saltos durante su recorrido, indicando que aún es mejorable el modelo en este aspecto.
  • aleatoriedad o ruido blanco: El gráfico de lags no muestra patrones.
  • una distribución dada: los gráficos de histograma y p-p Plot muestran una distribución aproximadamente normal centrada en cero (insesgado). Quizás haya una leve asimetría hacia la derecha por la caída izquierda del p-p Plot.
El nuevo modelo cumple bastante bien con los cuatro supuestos subyacentes. Aunque aún puede mejorarse. por ejemplo,
  • los gráficos muestran la existencia de 4 o 5 valores extraños, 
  • hay una asimetría muy leve que se puede tratar,
  • también hay oscilaciones en la amplitud vistas en el diagrama de secuencias que se podrían capturar volviendo a cambiar la constante C por un modelo más complejo.
Así y todo, los resultados son lo suficientemente satisfactorios para realizar inferencias. Así, adoptamos el nuevo modelo.

Conclusiones

La herramienta 4-plot desarrollada es muy efectiva para validar los cuatro supuestos subyacentes. Incluso nos aporta más información para resolver los hipótesis no cumplidas y pensar en un nuevo modelo.

 Este es el listado de preguntas que se pueden responder con este set de gráficos:
  1. Está el proceso en control; es estable y predecible?
  2. El proceso muestra tendencias en su posición?
  3. El proceso muestra tendencias en su variación?
  4. Los datos son aleatorios?
  5. Las observaciones están relacionadas con las observaciones adyacentes?
  6. Si los datos son una serie de tiempo, se trata de un ruido blanco?
  7. Si los datos son una serie de tiempo y no se trata de un ruido blanco, es un modelo autoregresivo o sinusoidal?
  8. Los datos o residuos siguen una distribución normal?
  9. Si no es normal, qué forma tiene la distribución?
  10. Es el modelo  Y = C + e  válido y suficiente?
  11. Si el modelo básico es insuficiente, hay posibilidad de mejorarlo?
  12. Es la varianza muestra un buen estimador de variación?
  13. Es la media muestral un buen estimador de posición?
  14. Si no lo fuera, cuál sería mejor?
  15. Existen valores extraños (outliers)? 

domingo, 29 de mayo de 2011

Análisis de Exploratorio de Datos (EDA) - 2

Exploración de información bivariada

La examinación de patrones y relaciones es tema central para la estadística. El diagrama de dispersión (scatterplot) es una herramienta simple de examinación de datos apareados que hasta nuestros días no ha perdido su importancia.

El siguiente ejemplo lo extraje de la librería R DAAG (para instalarla, ejecutar install.packages("DAAG") y luego library(DAAG). Más información de esta librería aquí).
2 tipos de leche fueron catadas por 17 personas. Un tipo de leche tiene agregado una medida de edulcorante y la otra cuatro medidas. Los catadores deben hallar la medida de edulcorante.

Los 17 resultados son:

-&gt; milk

  four one
1  7.2 5.8
2  7.4 6.9
3  7.0 6.0
4  7.2 6.0
5  4.6 5.4
6  6.0 5.7
7  5.0 6.1
8  4.2 3.7
9  3.8 3.8
10 6.1 4.3
11 3.7 3.4
12 3.9 1.4
13 2.5 1.7
14 4.4 5.4
15 4.2 3.2
16 4.6 2.2
17 5.6 3.6
 
La relación entre pares  puede apreciarse con un gráfico de dispersión
 
xyrange <- range(milk) #rango de valores

plot(four ~ one,data=milk,xlim=xyrange,ylim=xyrange,pch=16)
 
Las siguientes instrucciones agregan puntos de referencia de los puntos muestrales junto a los ejes cartesianos y una recta de 45 grados.
 
rug(milk$one ,side=1) #regla de valores en el eje x

rug(milk$four,side=2) #regla de valores en el eje y
abline(0,1) #recta de 45 grados

Ajuste de una curva

La puntuación dada por los catadores está claramente influenciada por su paladar, y parace que no hallan diferencias entre ambas (no al menos de ser un alecha 4 veces más dulce que la otra).
Para formalizar un poco más la relción hallada, se recurre a trazar una curva o recta de regresión entre los puntos datos. Existen para ellos varios algoritmos, entre ellos el más conocido es la recta de regresión lineal por mínimos cuadrados. En el siguiente gráfico presentamos este método (rojo) y otro más sofisticado (Regresión polinómica local) (verde) para apreciar diferentes resultados, aunque, para este ejemplo, iguales conclusiones.

Código R:
xyrange <- range(milk)

plot(four~one,data=milk,xlim=xyrange,ylim=xyrange,pch=16)
rug(milk$one ,side=1) #regla de valores en el eje x

rug(milk$four,side=2) #regla de valores en el eje y
fit <- lm(milk$four~milk$one)                   
abline(0,1) #recta de 45 grados
lines(fit$fitted.values ~ milk$one,lwd=2, col=2) #regresión mínimos cuadrados
lines(lowess(milk$one,milk$four),lwd=2,col=3)  #regresión polinòmica local

sábado, 28 de mayo de 2011

Análisis de Exploratorio de Datos (EDA)

El análisis exploratorio de datos consiste en un conjunto de técnicas que describen provisionalmente los datos recogidos. Se intenta de esta forma hacerlos hablar por sí mismos antes de comenzar un análisis formal. El término "Exploratory Data Analysis" (EDA), pertenece a John Tukey, con su libro de 1977 "Análisis exploratorio de datos".

Un análisis efectivo de EDA presenta los datos de tal manera que permite al cerebro humano detectar patrones. EDA permitiría:
  • Ayudar al razonamiento inductivo para sugerir ideas.
  • Desarrollar y comprender aspectos teóricos
  • Facilitar la validación de supuestos
  • Hallar conclusiones adicionales al objetivo primario
El conjunto de herramientas disponibles es muy variado, e incluso creciente con los continuos avances en técnicas de presentación de datos que ofrece la informática. Los principales gráficos son:
  • histogramas y funciones de densidad
  • gráficos de árbol (steam and leaf)
  • diagramas de cajas (boxes)
  • diagramas de dispersión
  • mapas de calor
  • diagramas de nodos (trellis diagram)
Vistas de una variable simple
Histograma
Permite observar la cantidad de observaciones en diferentes intervalos de la variable. Se presenta en forma de gráfico de barras.

El histograma permite responder las siguientes preguntas:

  1. ¿Qué tipo de distribución tienen los datos?
  2. ¿Dentro de que rango se localizan la mayoría de los datos?
  3. ¿Qué tan dispersos se encuentran los datos?
  4. ¿Existe asimetría?
  5. ¿Existen Outliers?

Por ejemplo,el siguiente gráfico muestra el nivel en metros de las crecidas del río Nilo durante el período 1871-1970:

Código R:
hist(Nile,breaks=400 + (0:20)*50,col=terrain.colors(2), main="corrientes del Nilo (1871-1970)",xlab="Crecidas en mts", ylab="Frecuencia")


Para obtener los números de clases (columnas), existen varios criterios sugestivos, como tomar la raiz cuadrada del número de observaciones o tomar la regla de Sturgess (c = 1 + log2N). Sin embargo ninguno de ellos es exacto ni de necesaria aplicación. Tampoco las clases deben ser de igual longitud.

Todo depende de lo que se quiera ver. A mi entender, el histograma debe construirse de tal manera que no oculte rasgos esenciales de la muestra.

Así por ejemplo se da en la construcción de histogramas para monto de siniestros: suele existir una gran cantidad de siniestros de valor $ 0. En dicho caso es conveniente graficar la primer columna con este único valor ($0) y luego elegir un esquema de distribución según la magnitud de los siniestros. Inclusive, si el 5-10% de los siniestros más grandes serían muy dispares del resto, convendría agruparlos todos en le último escalón del histograma y enumerarlos debajo para advertir al lector sobre su ubicación y valor.


Funciones de densidad


Al intentar parametrizar un fenómeno, suele estarse interesado en hallar su función de densidad. Para ello se grafica inicialmente el histograma.

Lo primero en que se puede pensar es que la función de densidad es la normalización del histograma por el tamaño de la muestra N. La división de las clases por N nos mostrará un set de probabilidades discretas, aún así se tienen inconvenientes con la forma de la distribución si es que las clases no son equidistantes y de base = 1.

Una primera forma de solucionarlo es tomando en cuenta la longitud de cada clase, de manera tal que el área del histograma sea igual a 1.

Aunque también es válido obtener una función de densidad empírica a través del suavizamiento del histograma. Los métodos de suavizamiento son variados, desde una media móvil de N muestras hasta procedimientos más avanzados. El uso de diferentes ventanas Kernel podría darnos el siguiente resultado:
 
Código R: 
hist(Nile,breaks=400 + (0:20)*50,col=terrain.colors(2), main="corrientes del Nilo (1871-1970)",xlab="Crecidas en mts", ylab="Frecuencia", probability = TRUE)

densRct <- density(Nile, kernel="rectangular")
lines(densRct,col="red",lwd=2)
densGauss <- density(Nile, kernel="gaussian")
lines(densGauss,col="blue",lwd=2)
densRctx2 <- density(Nile, kernel="rectangular", adjust=2)
lines(densRctx2,col="red",lwd=4)
densGaussx0.5 <- density(Nile, kernel="gaussian", adjust=0.5)
lines(densGaussx0.5,col="blue",lwd=1)


Se graficaron 4 suavizamientos. En rojo tenemos el uso de una ventan rectangular, siendo la línea gruesa una ventana más ancha (por eso sale más suavizada y chata).
En azul se grafican dos líneas que utilizan una ventana gaussiana (asume que cada punto muestral se distribuye normalmente). Estas últimas tienen la ventaja de "mezclar" mejor la contribución de cada observación a las observaciones adyacentes.
Podemos apreciar que según el método de suavizamiento se utilice, los resultados pueden variar. Esta es la principal desventaja del suavizamiento. Aunque es de mencionar que similares deformaciones se producen al elegir el ancho de las columnas del histograma.

Diagramas de árbol (Steam and Leaf)

Estos diagramas son una forma también rápida de visualizar una muestra. Posee las mismas características que un histaograma, aunque se concentra más en el contenido de las columnas que en su forma.
Se trata de un ordenamiento de una variable numérica que tine como tamaño de grupo al cociente entre el tamaño de la muestra y la cantidad de "ramas" (Steam) que se quiere utilizar. Como "hojas" del árbol (Leafs), se tiene el residuo de cada observaciòn al realizarse la división entera entre tamaño de muestra y ramas.

Por ejemplo, continuando el ejemplo de las inundaciones producidas por el Nilo, tenemos el siguiente diagrama de árbol de 13 ramas (ancho = 100):

> stem(Nile)
 
The decimal point is 2 digit(s) to the right of the |
   4 | 6
   5 |
   6 | 5899
   7 | 000123444455667778
   8 | 000011222233344555556667779
   9 | 0011222244466678899
  10 | 0122234455
  11 | 00012244566678
  12 | 112356
  13 | 7


La primera observación es 400 + 60 = 460. En el séptimo grupo, puede apreciarse una concentración de valores a izquierda: contiene 10 valores (1 de valor 1000 + 0 =1000, 1 de valor 1000 + 10 =1010, 3 de valor 1000 + 20 =1020, 1 de valor 1000 + 30 =1030, 2 de valor 1000 + 40 =1040, 2 de valor 1000 + 50 =1050), en el rango 1000-1050, peor ninguno en su extremo derecho 1050-1100.

Si se hubiera reducido la cantidad de ramas  a 5, obtendríamos:

stem(Nile,scale=5/10)
 
The decimal point is 2 digit(s) to the right of the |
   4 | 6
   6 | 5899000123444455667778
   8 | 0000112222333445555566677790011222244466678899
  10 | 012223445500012244566678
  12 | 1123567


Diagramas de cajas

Los diagramas de cajas permiten visualizar aspectos importantes de la muestra con una cantidad reducida de datos.
La "caja" contendrá la mitad de los datos centrales (datos entre percentiles 25 y 75); una línea (mediana o percentil 50) la dividirá. Dos líneas saldrán  a los costados de las cajas (denominados habitualmente "whiskers" o bigotes); estas mostrarán el rango de la muestra. Al realizarse el diseño, los programas ya dejan afuera los casos que consideran extraños por estar alejados del resto de las observaciones (habitualmente se toman tres rangos intercuatílicos (percentil 75 - percentil 25) * 3 ).

Por ejemplo, el diagrama de cajas que nos toca con el ejemplo dado es el siguiente:

Código R:
boxplot(Nile, col = "orange", horizontal = TRUE, main="Corrientes del Nilo (1871-1970)", xlab="crecidas en mts")
Con el diagrama de cajas puede apreciarse una distribución bastante simétrica, que está en línea con lo observado en el histograma.